Як налаштувати ШІ-агента для перевірки коду: досвід GitLab, Preply та Kube-DC
Розробники дедалі частіше доручають перевірку коду штучному інтелекту. Експерти з GitLab, Preply, Superhuman і Kube-DC розповіли, як організувати цикл «агент перевіряє агента», які моделі поєднувати та де ШІ досі помиляється.
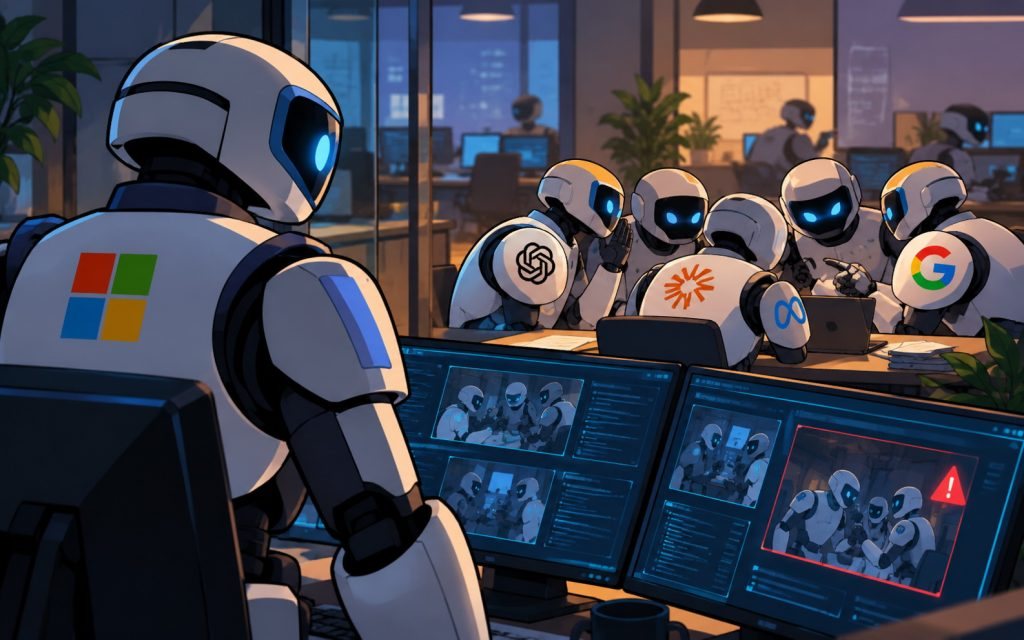
Перевірка коду за допомогою штучного інтелекту вже давно вийшла за межі простого запиту до чат-бота. Сучасні команди будують цілі цикли, де один агент пише код, другий шукає в ньому проблеми, а третій оцінює слушність зауважень. Про те, як налаштувати таких асистентів і де вони досі помиляються, розповіли Ілля Климов із GitLab, Володимир Цап із Shalb і Kube-DC, Ярослав Єрмілов із Superhuman та Владислав Левковський із Preply.
Причина популярності ШІ-рев’ю — масштаб. Коду стає більше, і перевіряти його по-старому дедалі складніше. У GitLab поставили за мету вийти на 500 мердж-реквестів на інженера на місяць до кінця року. За таких обсягів людське рев’ю стає слабким місцем: один MR іноді перевіряють від двох до десяти людей. У Kube-DC ситуація інша — над проєктом на 1,2 млн рядків коду працювали троє замість запланованих 15. А Ярослав Єрмілов у Superhuman, працюючи над прототипами сам, використовував ШІ хоча б як додаткову пару очей.
Є й дисбаланс: якщо автор генерує код зі ШІ швидше, то рев’юер отримує більше роботи. ШІ може перебрати на себе механічні перевірки, а людина зосередиться на тому, чи потрібна зміна взагалі і чи правильна архітектура. Ярослав наводить приклад дизайн-системи: десятки чи сотні елементів на відповідність правилам агент перевірить, не втомившись. Натомість там, де потрібен компроміс, за словами Владислава Левковського, ШІ працює гірше. «Цінність людини полягає в тому, що ми можемо знаходити такий компроміс», — пояснює він.
Підходи до створення інструменту різняться. Ілля Климов у GitLab взяв готове рішення і докрутив: користується вбудованим ШІ-агентом для код-рев’ю, а поверх нього побудував дві власні стадії перевірки, які запускаються локально ще до стандартного серверного процесу. Володимир Цап із Shalb окремого рев’ю-інструмента не робив. Його команда спершу вручну, без ШІ, написала фундамент Kube-DC — 50-60 тисяч рядків базових рішень, які мали спиратися на людський досвід. Моделі й інструменти підключили вже до цього кістяка.
Ярослав Єрмілов розповідає, що «ХакерМанго» починався як дуже простий прототип. Першу версію фактично побудували навколо одного короткого промпту: «Зроби рев’ю цього pull request». За його словами, цього вже вистачило приблизно на 80% результату. Він радить спробувати готові рішення, якщо ж сильної внутрішньої команди для такого проєкту немає. Спершу його агент навчився не лише аналізувати код, а й взаємодіяти з розробником: міг опублікувати зауваження в GitHub, прочитати відповіді на них, оцінити аргументи розробника й погодитися або не погодитися з ними. Наступним кроком стало розділення завдань між кількома агентами. «Ми починали з одного агента, який отримував інструкцію „зроби рев’ю“, а далі перейшли до того, що є головний агент, який запускає цілий набір інших — від трьох до п’ятнадцяти окремих агентів», — каже Ярослав Єрмілов.
У Preply рев’юер спершу був частиною бота, що автономно допомагав розробляти задачі. Готові рішення, як-от Codex чи Cursor, добре знаходили edge cases і баги, але, за словами Владислава Левковського, не враховували внутрішні правила компанії, складність рішень і головне питання: чи потрібна ця зміна взагалі. Тож команда паралельно прогнала власний рев’юер і готові інструменти на однакових тестових pull request. В одному з них навмисно заклали сім порушень внутрішніх DDD-правил. Власний рев’юер знайшов усі сім. CodeRabbit показав у звичайних коментарях лише три, а ще чотири позначив як мінорні. Після цього, а також після фідбеку розробників на реальних PR, команда вирішила розвивати власного рев’юера.
У GitLab Ілля Климов додав перед вбудованим ШІ-рев’юером ще два етапи, які запускаються локально. Перший рев’юер працює на моделі іншого сімейства, ніж та, що писала код. За словами Іллі, моделі схильні краще оцінювати код, створений ними самими або моделями того ж сімейства. Тому якщо код він пише з моделями Anthropic, рев’ю робить модель OpenAI. Її завдання не лише шукати помилки, а й перевірити, чи реалізація відповідає задачі. Наприклад, для виправлення таблиці на малих екранах модель спершу дивиться відео з результатом, а потім читає код. Так вона оцінює те, що складно перевірити звичайними інструментами: чи адекватно поводиться інтерфейс і чи це те, що просили. Механічні перевірки Ілля свідомо залишає лінтерам та іншим детермінованим інструментам.
Другий етап — рев’юер першого рев’юера. Ця модель перевіряє не код, а зауваження: чи справді вони потрібні й чи не суперечать вимогам проєкту. Перша модель, наприклад, пропонує обробити дуже довгий текст у таблиці. Друга з’ясовує, що така ситуація вже неможлива завдяки перевіркам на сервері й фронтенді, і зайві 20 рядків відпадають. В іншому випадку перша радить старий CSS-клас Bootstrap, хоча проєкт мігрує на нову систему. Друга відхиляє пораду й нагадує про нові атомарні класи. Але відхилені зауваження не завжди закривають питання — якщо моделі не погоджують позиції, остаточне рішення ухвалює людина.
4