Revolut знизив витрати на ШІ-програмування на 90%, перейшовши на власну модель GLM
Фінтех-компанія Revolut відмовилася від Claude Code на користь self-hosted відкритої моделі GLM, що дозволило скоротити витрати на ШІ-кодування майже на 90% за менш ніж рік і пришвидшити роботу розробників.
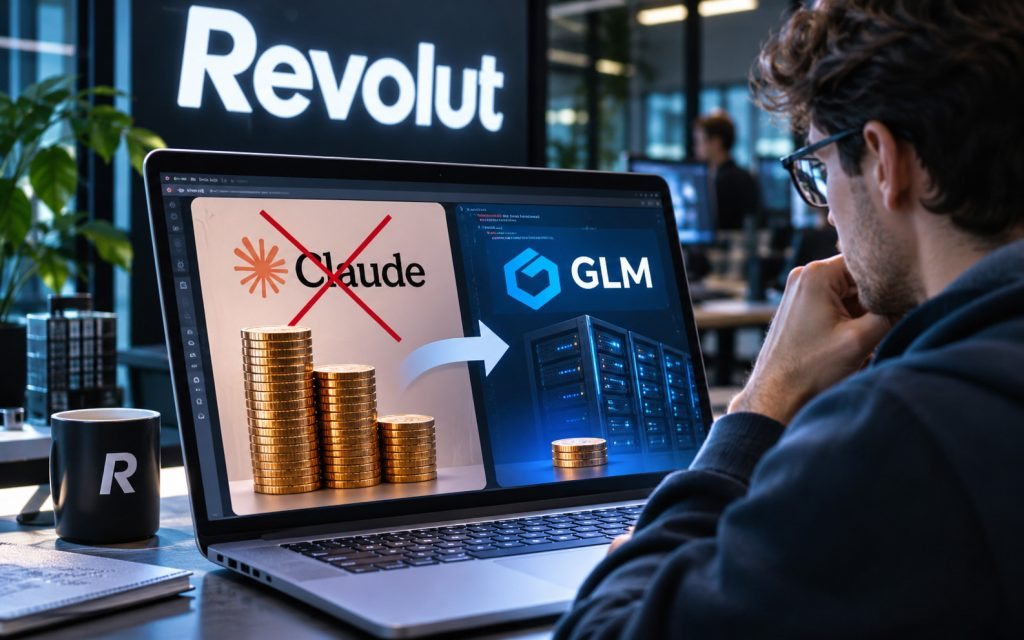
Британський фінтех-гігант Revolut скоротив витрати на ШІ-інструменти для програмування майже на 90% за менш ніж рік. Компанія відмовилася від комерційного сервісу Claude Code і перевела свою команду розробників на власноруч розгорнуту відкриту мовну модель GLM. За словами керівника напряму операцій та інфраструктури Revolut Девіда Абітбола, який виступав на конференції AI Engineer у Нью-Йорку, зміна дала не лише економію, а й відчутний приріст швидкості роботи.
Зараз локальні ШІ-інструменти для кодування використовують близько 2 000 розробників компанії. За даними Абітбола, час написання коду скоротився на 60%, а показник lead time, тобто часу від початку роботи над завданням до її впровадження, покращився на 70%. Найбільший ефект, за його словами, дало використання моделі для налагодження коду та роботи із завданнями в Jira і Confluence. Таким чином, зекономлені ресурси пішли не лише на зниження рахунків, а й на прискорення повсякденних процесів команди.
Шлях до такого рішення почався з помітного тиску на витрати. На початку 2025 року Revolut використовував Gemini, а на початку 2026-го перейшов на Claude Code. За інформацією джерел, рахунки за ці сервіси викликали занепокоєння керівництва: окремі інженери, як повідомляється, генерували витрати від 1 000 до 10 000 доларів на місяць. Після переходу на GLM-5.1 вартість обробки одного мільйона токенів склала близько 0,30 долара, що приблизно в десять разів дешевше. Згодом компанія оновила модель до версії GLM-5.3.
Модель розробляє китайська компанія Z.ai. Вона має близько 754 мільярдів загальних параметрів, із яких 40 мільярдів активні для кожного токена. Для розміщення ваг моделі потрібно близько 380 ГБ відеопам'яті, а контекст кожного користувача додає ще від 6 до 26 ГБ. Revolut запускає модель на 56 графічних процесорах Nvidia B200, тобто на семи системах DGX B200. Прискорення роботи, за словами компанії, забезпечили квантування NVFP4 і розділення етапів prefill та decode, що дозволило обробляти запити ефективніше.
Абітбол також звернув увагу на питання довжини контексту. За його оцінкою, контекст у мільйон токенів є радше пасткою, ніж перевагою, а для більшості завдань достатньо близько 256 тисяч токенів. Оскільки GLM працює лише з текстом, Revolut використовує маршрутизатор моделей, який передає візуальні завдання іншим системам, зокрема моделям класу Gemini або GPT.
Щодо безпеки даних Абітбол наголосив, що головний ризик для приватності пов'язаний із API, розміщеними в Китаї, а не з локальним розгортанням моделі на власній інфраструктурі. Саме цей аргумент, за його словами, став одним із чинників вибору self-hosted підходу. Історія Revolut показує, як великі компанії дедалі частіше розглядають власне розгортання відкритих моделей як альтернативу дорогим хмарним сервісам, особливо коли мова йде про тисячі розробників, які щодня користуються ШІ-інструментами.
Джерело: highload.tech
4